Chi governa la conoscenza governa anche l’Intelligenza Artificiale.
Negli ultimi anni abbiamo assistito a una corsa senza precedenti verso modelli di Intelligenza Artificiale sempre più grandi, potenti e capaci di svolgere compiti che, fino a poco tempo fa, sembravano esclusivamente umani.
Il dibattito si concentra spesso su quale modello sia più intelligente, quale azienda abbia conquistato il primo posto nelle classifiche o chi presenterà la prossima grande novità.
Forse, però, continuiamo a porci la domanda sbagliata.
Non dovremmo chiederci soltanto:
Quanto è intelligente un modello?
Dovremmo chiederci anche:
Chi decide che cosa sa?
Un sistema di Intelligenza Artificiale, infatti, non vive soltanto del modello che utilizza. Vive anche della conoscenza sulla quale costruisce le proprie risposte. E mentre i miliardi di parametri di un modello possono sfuggire al nostro controllo, la conoscenza può essere selezionata, verificata, organizzata e governata.
È da questa riflessione che nasce il nostro nuovo lavoro, pubblicato su Earth Science Informatics.
Dal modello alla conoscenza
I Large Language Models hanno dimostrato capacità sorprendenti. Sanno produrre testi convincenti, sintetizzare documenti, spiegare concetti complessi e dialogare con una naturalezza che fino a pochi anni fa sembrava fantascienza.
Ma quando entrano nel mondo della ricerca scientifica emerge un problema fondamentale: un modello può essere molto bravo a generare una risposta senza essere altrettanto bravo a distinguere ciò che è scientificamente affidabile da ciò che semplicemente suona bene.
E nella scienza, purtroppo, una risposta ben scritta ma sbagliata rimane una risposta sbagliata.
Per affrontare questo limite si è diffusa la Retrieval-Augmented Generation, o RAG, che consente al modello di consultare documenti esterni prima di rispondere.
La RAG, però, non è una bacchetta magica.
Collegare un modello a una cartella piena di documenti non rende automaticamente affidabili le sue risposte. Una biblioteca non diventa autorevole soltanto perché contiene molti libri: bisogna sapere chi li ha scelti, da dove provengono, quanto sono aggiornati e con quali criteri vengono utilizzati.
Da qui nasce una domanda decisiva:
Chi sceglie la conoscenza che l’Intelligenza Artificiale può consultare?
È proprio su questo terreno che, secondo noi, si gioca una parte importante del futuro dell’AI scientifica.
Researcher-Curated Knowledge Governance
Nel nostro lavoro introduciamo il concetto di Researcher-Curated Knowledge Governance.
L’idea è semplice, ma le sue conseguenze sono profonde.
I ricercatori non dovrebbero limitarsi a produrre conoscenza scientifica. Dovrebbero poter selezionare, validare, organizzare, aggiornare e governare anche la conoscenza utilizzata dai sistemi di Intelligenza Artificiale.
In questo modo il corpus non è più una raccolta casuale di documenti pescati dal web, ma diventa un patrimonio scientifico curato consapevolmente.
La conoscenza smette di essere soltanto il carburante dell’algoritmo e diventa una vera infrastruttura.
Una simile impostazione rende il sistema più trasparente, più riproducibile e più facile da verificare. Permette inoltre alle istituzioni di assumersi la responsabilità delle fonti utilizzate e di mantenere il controllo sul proprio patrimonio scientifico.
In altre parole, non basta governare il software.
Bisogna governare anche ciò che il software sa.
L’approccio RockGPT
Per mettere alla prova questa idea abbiamo sviluppato RockGPT, una piattaforma pensata per le geoscienze.
RockGPT combina:
- Large Language Models open source;
- Retrieval-Augmented Generation;
- conoscenza scientifica curata dai ricercatori;
- infrastrutture self-hosted sotto il controllo dell’istituzione.
L’obiettivo non è costruire il chatbot più brillante della stanza.
L’obiettivo è costruire un assistente scientifico del quale ci si possa fidare.
Le risposte non devono soltanto sembrare convincenti. Devono essere fondate su fonti scientifiche selezionate e mantenute da esperti del settore, essere tracciabili e poter essere controllate.
È una differenza sottile soltanto in apparenza. In realtà è la differenza tra un sistema che produce testo e un sistema che può diventare parte responsabile del processo scientifico.

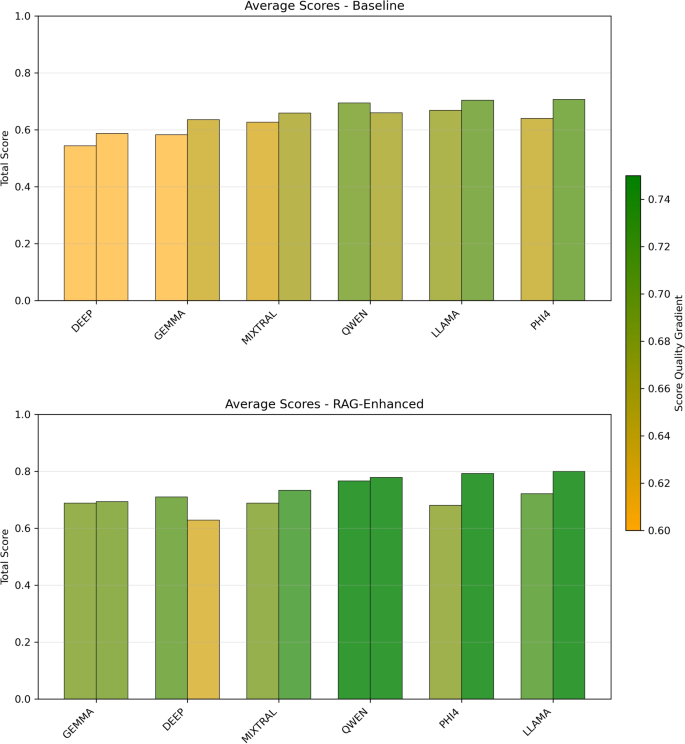
Punteggi medi dei modelli nelle configurazioni baseline e RAG-enhanced (Figura 4).
Perché è importante per l’Europa
Negli ultimi mesi si parla sempre più spesso di AI sovereignty, la sovranità dell’Intelligenza Artificiale.
Il dibattito, però, tende a concentrarsi quasi esclusivamente sulla costruzione di nuovi modelli europei capaci di competere con quelli statunitensi o cinesi.
Sviluppare modelli europei è certamente importante, ma la sovranità non può fermarsi al modello.
Un modello aperto che utilizza infrastrutture, dati e conoscenza controllati da altri non è necessariamente sovrano.
La vera sovranità riguarda l’intera catena: modelli, dati, fonti scientifiche, infrastrutture, processi decisionali e responsabilità istituzionali.
Da questo punto di vista, grandi infrastrutture europee di ricerca come EPOS rappresentano un terreno ideale. Riuniscono dati FAIR, servizi scientifici, competenze distribuite e una governance istituzionale già consolidata.
Sono quindi ambienti naturali nei quali costruire servizi di Intelligenza Artificiale affidabili e sovrani, capaci di sostenere la ricerca senza consegnare conoscenza, dati e processi decisionali a piattaforme esterne.
Forse il vantaggio competitivo dell’Europa non sarà costruire il modello più grande.
Potrebbe essere costruire l’ecosistema più affidabile.
Non vincere la gara dei muscoli, insomma, ma quella della fiducia.
Guardando avanti
La Researcher-Curated Knowledge Governance non vuole sostituire i Large Language Models.
Vuole metterli nelle condizioni di diventare strumenti scientifici migliori.
Se l’Intelligenza Artificiale entrerà sempre più profondamente nel lavoro dei ricercatori, la domanda decisiva non sarà soltanto quanto sia intelligente.
Dovremo domandarci anche quanto possiamo fidarci della conoscenza sulla quale ragiona, chi l’ha selezionata, chi la aggiorna e chi se ne assume la responsabilità.
Perché l’Intelligenza Artificiale è tanto affidabile quanto la conoscenza che le affidiamo.
Ed è proprio qui, secondo noi, che comincia una AI scientifica davvero degna di fiducia.
Paper
Researcher-Curated Knowledge Governance for Trustworthy Scientific AI in the Geosciences: the RockGPT Approach
Pubblicato su Earth Science Informatics.
https://link.springer.com/article/10.1007/s12145-026-02197-5
Nota di trasparenza: la stesura di questo articolo è stata supportata dall’intelligenza artificiale generativa. Il contenuto è stato successivamente revisionato, verificato e approvato dall’autore.